VoxCPM2 应该下载到本地,还是在线试用?
找到上游 VoxCPM2 权重,分清 GitHub 与 Hugging Face、浏览器试听与 Python 本地运行,以及 Python API 与本站账号。
想先听 VoxCPM2 的效果,可以从浏览器开始。需要控制本地文件或自行集成,可以自己运行模型。VoxCPM.net 是独立在线服务,并非 OpenBMB 官方项目网站。
我应该从哪里开始?
- 听已有录音。 打开 OpenBMB 的 VoxCPM2 样音集。
- 在线生成自己的短文本。 打开文字转语音工具,以当时显示的额度和登录提示为准。
- 自己运行模型。 如果能够维护 Python、PyTorch 环境,可以使用下面的示例。
本站的两段真实生成样音和播放、下载步骤,见文字转语音音频教程。
到哪里下载代码和权重?
上游 GitHub 仓库提供实现、安装说明和示例。下载源码 ZIP 不等于下载了模型权重。
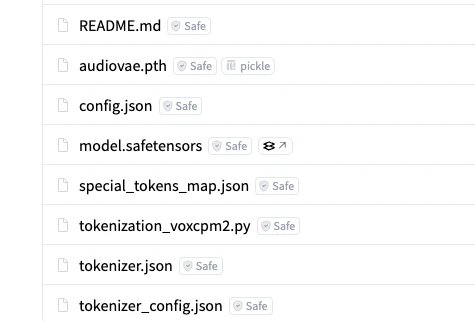
上游 Hugging Face 文件列表包括 model.safetensors、audiovae.pth、配置和分词器文件。应下载完整模型快照,而不是只取一个权重文件。Python 的 VoxCPM.from_pretrained("openbmb/VoxCPM2") 会在首次加载时下载快照,之后使用本地缓存,也可以接收已下载完整快照的目录。这些行为可在上游加载器源码中核对。
请使用准确的模型 ID openbmb/VoxCPM2。VoxCPM1.5 和 VoxCPM-0.5B 是其他版本。
怎么用 Python 生成 WAV?
上游快速开始建议使用 Python 3.10–3.12、PyTorch 2.5 或以上,CUDA 环境要求 CUDA 12 或以上。先安装适合自己显卡和驱动的 PyTorch 构建。模型卡列出约 8 GB 显存,这是估计值,不保证所有 8 GB 显卡、所有输入都能运行。
在已激活的虚拟环境中,安装本文核对过的版本。
python -m pip install 'voxcpm==2.0.3'
将下面内容保存为 synthesize.py,执行 python synthesize.py。首次加载需要联网下载权重。
import soundfile as sf
from voxcpm import VoxCPM

model = VoxCPM.from_pretrained("openbmb/VoxCPM2", load_denoiser=False)
wav = model.generate(
    text="你好,这是一段 VoxCPM2 语音演示。",
    cfg_value=2.0,
    inference_timesteps=10,
)
sf.write("output.wav", wav, model.tts_model.sample_rate)
这是模型卡基础 TTS 示例的等效写法,不需要参考录音。保存时保留 model.tts_model.sample_rate。VoxCPM2 输出为 48 kHz,不要套用旧版 VoxCPM 示例的 16 kHz 设置。
如果复制的代码提示不接受 seed 参数,使用 2.0.3 时请删除它。当前 GitHub README 包含这个参数,但已发布的 2.0.3 包不接受。
生成后检查文件。
python -c 'import soundfile as sf; i = sf.info("output.wav"); print(i); assert i.format == "WAV" and i.frames > 0 and i.samplerate == 48000'
然后完整试听。WAV 可读取、采样率正确,并不意味着每个字都读对了。
使用 Python API 需要本站账号吗?
不需要。这里的 Python API 指安装的 voxcpm 库中的函数,在你的环境中推理,无需 VoxCPM.net 账号或 API Key。本站账号用于本站工具,不代表获得了托管开发者 API 的使用权限。
截至 2026 年 11 月 15 日,本文核对了上游说明和安装包函数签名,未实际运行本地推理或测试硬件性能。